Скользищие окна и сложная задача
Пример использование скользощяего окна на проблеме в samdu2al.uz
 Xaydarov Zafar AlamovichPRO
08 Oktabr 2026 · 3 daqiqa o‘qish
25
4
Найдите длину самой длинной непрерывной части строки, в которой буквы не повторяются.
Примеры
Вход
abcabcbb
Выход
3
Первые мысли
Поставьте лайк!
Ладно
Давайте начнем
В начале я подумал что можно легко пройтись с циклом фор и решить задачу
Код
s = input()
c = set()
for i in s:
    if i in c:
        break
    else:
        c.add(i)
print(len(c))
В итоги, код представляет собой неэффективный текст, практически не выполняющий полезных функций. Кроме того, он вызывает исключение по превышению лимита времени и содержит ошибки в логике работы.
На самом деле есть вариант полутше
Давайте мы рассмотрим его
def longest_substring(s):
    answer = 0

    for left in range(len(s)):
        for right in range(left, len(s)):
            is_acceptable = True
            char_set = set()

            for i in range(left, right + 1):
                if s[i] in char_set:
                    is_acceptable = False
                    break

                char_set.add(s[i])

            if is_acceptable \
                    and answer < right - left + 1:
                answer = right - left + 1

    return answer
Решение перебором
1 - Переберем все возможные подстроки
2 - Дла каждой из них проверям, есть ли в ней одинаковые буквы
3 - Вернем размер самой длинной подходящей подстроки
Чтож
В начале создаем 2 цикл for, переменную is_acceptable = True и char_set
Так же создаем другой цикл в котором проверяем если s[i] in char_set: то меняем переменную is_acceptable на False
Каждая комбинация left и right задает подстроку которая начинается в left и заканчивается в right
Посмотрим на пример
Изначально left и right указывают на букву a поэтому мы обрабатываем a
Затем right сдвинется на букву b и мы обработаем подстроку ab затем с b a d and etc
В третьем цикле переменная i будем бежать по подстроке и для каждой такой буквы проверяется также как было написано выше
Дальше простая проверка и return answer
Понять и сделать всего лишь вот этот код было не простой для меня задачкой
Но дальше ХУЖЕ
Оказалось что мой ответ неправилен так как он был медленным
Понятное дело что O(n)³ никак не пройдет тесты на 10**9
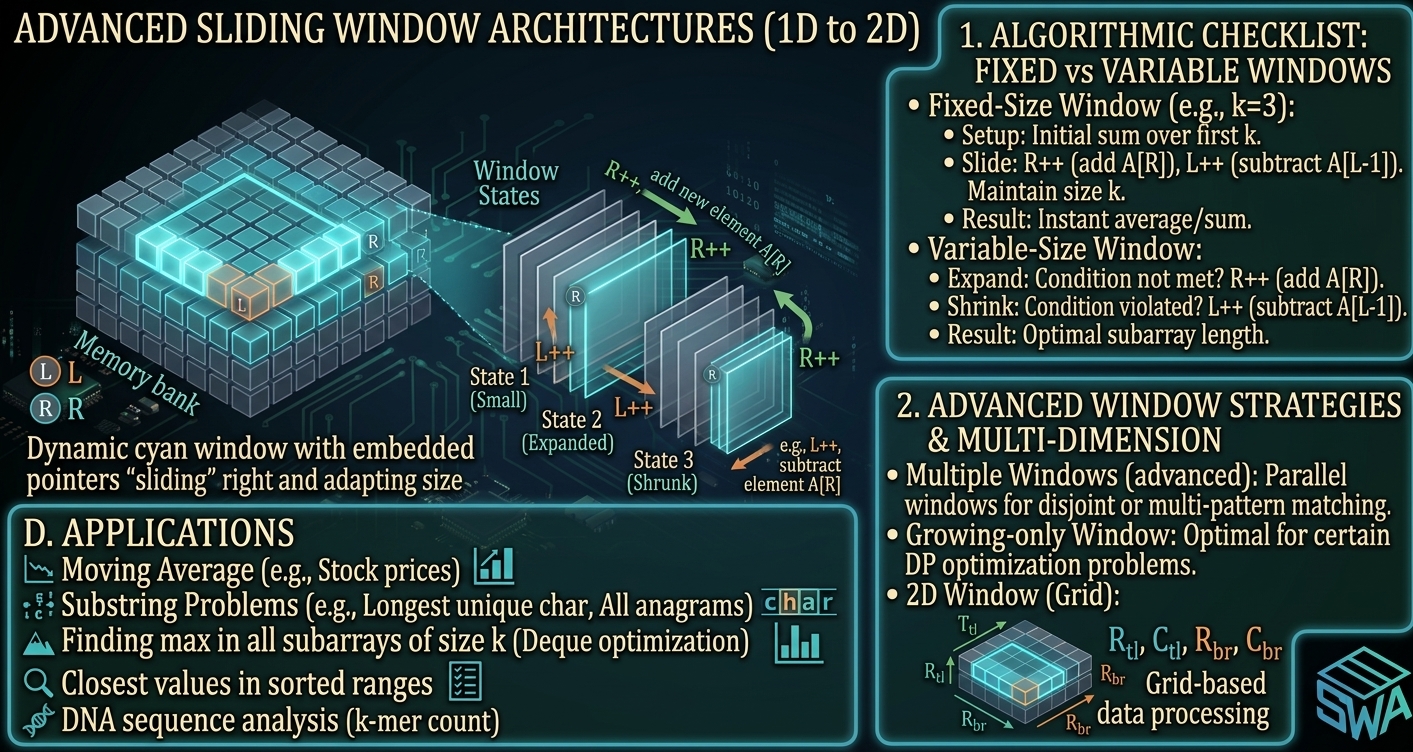
(Здесь идет картинка со схемой работы L и R)
На картинке выше указана формула, как решить эту задачу, используя скользящее окно.
В начале мы создаем два указателя left и right.
Дальше мы проверяем:
- Right двигается на += 1, если значения нет в сете.
- Если right обнаружил дубликат, то начинает двигаться left.
- Пока двигается left, он удаляет значения, и как только left и right будут на одной переменной, начинается новый цикл, и right также продолжает проходить.
Решение
s = input()

c = set()
ans = 0
l = 0

for r in range(len(s)):
    while s[r] in c:
        c.remove(s[l])
        l += 1
    c.add(s[r])
    ans = max(ans,len(c))

print(ans)
Наверху находится более оптимальная и упрощенная версия, которая делает то же самое, что и код, находящийся ниже.
s = input()

max_length = 0
left = 0

for right in range(len(s)):
    # Текущее окно — это кусок строки от left до right.
    # Если новая буква s[right] уже есть внутри этого окна:
    while s[right] in s[left:right]:
        # Значит нужно сдвигать левую границу, пока повтор не исчезнет
        left += 1

    # Считаем длину текущего окна без повторов
    current_length = right - left + 1

    # Обновляем максимальную длину, если нашли окно побольше
    if current_length > max_length:
        max_length = current_length

print(max_length)