Бинарный поиск и его основы
Бинарны поиск алгоритм
 Xaydarov Zafar AlamovichPRO
07 Oktabr 2026 · 6 daqiqa o‘qish
25
3
Полное руководство по алгоритму бинарного поиска
Введение: Что такое бинарный поиск
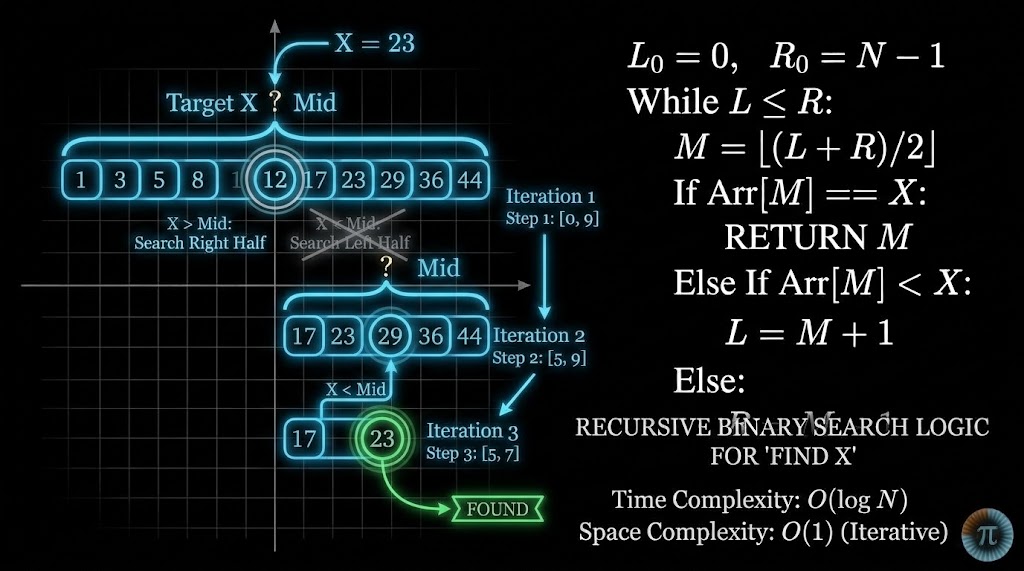
Бинарный поиск (дихотомия) — это эффективный алгоритм поиска элемента в отсортированном массиве (или списке). Основная идея алгоритма заключается в многократном разделении области поиска пополам. На каждом шаге алгоритм сравнивает искомое значение с элементом, находящимся в середине текущего отрезка. Если значения совпадают, поиск завершается. Если искомое значение меньше среднего элемента, поиск продолжается в левой половине отрезка, если больше — в правой.
Главное условие: бинарный поиск работает исключительно на отсортированных данных. Если массив не отсортирован, применение алгоритма невозможно без предварительной сортировки.
Асимптотическая сложность (скорость работы):
Временная сложность бинарного поиска составляет O(log N), где N — количество элементов в массиве. Это означает, что при увеличении размера массива в два раза потребуется всего одна дополнительная операция. Для массива из 1 000 000 элементов алгоритму потребуется не более 20 проверок.
---
Глава 1. Классический бинарный поиск
Задача: Найти индекс заданного элемента в отсортированном массиве. Если элемента нет, вернуть -1.
Код на Python:
def binary_search(arr, target):
    left = 0
    right = len(arr) - 1

    while left <= right:
        # Находим индекс среднего элемента
        mid = (left + right) // 2

        if arr[mid] == target:
            return mid          # Элемент найден
        elif arr[mid] < target:
            left = mid + 1      # Отбрасываем левую половину
        else:
            right = mid - 1     # Отбрасываем правую половину

    return -1                   # Элемент не найден
Объяснение алгоритма:
- Инициализируются два указателя: left (указывает на начало массива) и right (указывает на конец).
- Запускается цикл, который работает до тех пор, пока левая граница не превысит правую.
- Вычисляется середина отрезка: mid. (В языках типа C++ или Java рекомендуется писать left + (right - left) // 2 во избежание переполнения типов, но в Python встроенный тип целых чисел имеет произвольную длину, поэтому (left + right) // 2 безопасно).
- Если элемент в середине равен искомому, алгоритм возвращает его индекс.
- Если центральный элемент меньше искомого (arr[mid] < target), это значит, что искомый элемент может находиться только правее. Левая граница сдвигается на mid + 1.
- Если центральный элемент больше искомого, правая граница сдвигается на mid - 1.
---
Глава 2. Поиск границ (Lower Bound и Upper Bound)
В классическом бинарном поиске при нахождении элемента алгоритм сразу завершает работу. Но что если массив содержит дубликаты (например, [1, 2, 2, 2, 3]), и нам нужно найти индекс первого вхождения числа 2 или последнего? Для этого алгоритм модифицируется.
Поиск левой границы (Lower Bound) - нахождение первого элемента, который больше или равен заданному значению.
Код на Python (Поиск первого вхождения):
def lower_bound(arr, target):
    left = 0
    right = len(arr) - 1
    result = -1

    while left <= right:
        mid = (left + right) // 2

        if arr[mid] >= target:
            result = mid        # Запоминаем текущий индекс
            right = mid - 1     # Продолжаем искать левее
        else:
            left = mid + 1      # Ищем правее

    return result
Объяснение:
- Когда мы находим элемент, равный target (или больше его), мы не останавливаем цикл.
- Мы сохраняем найденный индекс в переменную result, так как он может быть ответом.
- Затем мы сдвигаем правую границу (right = mid - 1), чтобы проверить, нет ли такого же элемента еще левее.
- По завершении цикла в result останется индекс самого левого подходящего элемента.
---
Глава 3. Бинарный поиск по ответу
Это наиболее мощное применение бинарного поиска. Оно используется в задачах оптимизации, где нужно найти минимальное или максимальное значение, удовлетворяющее определенному условию.
Главное требование: функция условия должна быть монотонной. То есть, если условие выполняется для числа X, оно должно выполняться и для всех чисел больше X (или меньше X, в зависимости от задачи).
Задача "Два принтера":
Есть два принтера. Первый печатает один лист за X секунд, второй — за Y секунд. За какое минимальное время они вместе напечатают N листов?
Код на Python:
def check(time, n, x, y):
    # Вычисляем, сколько листов напечатают оба принтера за заданное время
    pages = (time // x) + (time // y)
    return pages >= n

def min_time_to_print(n, x, y):
    left = 0
    # Худший случай: все листы печатает самый быстрый принтер
    right = n * min(x, y)
    best_time = right

    while left <= right:
        mid = (left + right) // 2

        if check(mid, n, x, y):
            best_time = mid     # Успели напечатать, запоминаем ответ
            right = mid - 1     # Пробуем найти время поменьше
        else:
            left = mid + 1      # Не успели, нужно больше времени

    return best_time
Объяснение:
- Мы не ищем элемент в массиве. Мы берем весь возможный диапазон времени от 0 до максимально возможного (right).
- mid здесь выступает в роли "предполагаемого времени".
- Функция check проверяет: успеют ли принтеры напечатать N листов за время mid. Если да, мы запоминаем это время в best_time и сдвигаем правую границу, пытаясь найти еще более короткое время.
- Если не успевают, мы понимаем, что времени нужно больше, и сдвигаем левую границу.
---
Глава 4. Вещественный бинарный поиск
Используется для поиска непрерывных (дробных) значений. В отличие от целых чисел, вещественный поиск не оперирует индексами +1 или -1, так как между любыми двумя дробными числами существует бесконечное множество других чисел.
Задача: Найти квадратный корень заданного числа N с точностью до 6 знаков после запятой, не используя встроенные математические функции.
Код на Python:
def square_root(n):
    if n < 0:
        raise ValueError("Корень из отрицательного числа не существует")
    if n == 0 or n == 1:
        return n

    left = 0.0
    right = max(1.0, n)
    epsilon = 1e-7 # Допустимая погрешность (точность)

    while right - left > epsilon:
        mid = (left + right) / 2.0

        if mid * mid <= n:
            left = mid      # Корень больше или равен mid
        else:
            right = mid     # Корень меньше mid

    # По завершении цикла left и right практически равны
    return round((left + right) / 2.0, 6)
Объяснение:
- Устанавливаем границы поиска. Нижняя граница 0. Верняя граница — это само число N (или 1, если число меньше 1).
- Задаем точность epsilon (например, 0.0000001).
- Цикл работает до тех пор, пока разница между правой и левой границей больше нашей точности (right - left > epsilon).
- Мы используем обычное деление (/), а не целочисленное (//).
- При сдвиге границ мы не прибавляем и не вычитаем 1, а просто приравниваем границу к середине (left = mid или right = mid).
- Как только отрезок сузится до размеров epsilon, цикл завершается, и среднее значение отрезка признается искомым корнем.
(Примечание: в спортивном программировании часто вместо проверки epsilon используют фиксированное количество итераций цикла, например for _ in range(100), так как 100 делений пополам гарантируют точность, превосходящую возможности стандартных типов данных).